Phần mềm Stata trong nghiên cứu kinh tế lượng
10/08/2025
Tìm hiểu về phần mềm Stata, công cụ mạnh mẽ trong nghiên cứu kinh tế lượng với các tính năng phân tích dữ liệu, mô hình hóa và lập trình linh hoạt.
Nghiên cứu kinh tế lượng hiện đại ngày càng phụ thuộc vào các công cụ phần mềm thống kê mạnh mẽ. Trong số các phần mềm phổ biến như SPSS, SAS, R và Python, Stata nổi lên như lựa chọn ưa thích của nhiều nhà nghiên cứu về kinh tế học, xã hội học và y học tại Việt Nam nhờ giao diện trực quan, cú pháp lệnh thân thiện và khả năng xử lý dữ liệu hiệu quả. Sinh viên các trường đại học nghiên cứu cũng như giảng viên tại các viện nghiên cứu thường lựa chọn Stata làm công cụ chính cho các đề tài luận văn, bài báo khoa học và dự án nghiên cứu thực tế.
Sự phổ biến của Stata tại Việt Nam đến từ hai yếu tố chính. Thứ nhất, phần mềm có tài liệu hướng dẫn tiếng Anh chi tiết và dễ tiếp cận, đồng thời cộng đồng người dùng lớn cung cấp nhiều nguồn tài liệu bổ sung. Thứ hai, nhiều trường đại học và viện nghiên cứu tại Việt Nam đã trang bị bản quyền Stata cho phòng thí nghiệm, giúp sinh viên tiếp cận công cụ này từ sớm. Đội ngũ biên tập EduCentury nhận thấy xu hướng chuyển dịch từ SPSS sang Stata trong các nghiên cứu xã hội học và kinh tế học tại Việt Nam đang tăng rõ rệt trong 5 năm qua.
Tổng quan về phần mềm Stata
Stata là phần mềm thống kê tích hợp được phát triển bởi StataCorp từ năm 1985, ban đầu dành cho nghiên cứu y học nhưng sau đó mở rộng sang nhiều lĩnh vực như kinh tế học, xã hội học, khoa học chính trị và sinh học thống kê. Phần mềm có nhiều phiên bản khác nhau từ Stata/BE (Basic Edition) cho người dùng cá nhân đến Stata/SE và Stata/MP cho các nghiên cứu quy mô lớn với dữ liệu lớn và cần xử lý song song. Mỗi phiên bản có giới hạn về số lượng biến, observation và khả năng sử dụng đa luồng khác nhau.
Giao diện Stata bao gồm 4 cửa sổ chính: Command (nhập lệnh), Results (hiển thị kết quả), Review (lịch sử lệnh) và Variables (danh sách biến). Người dùng có thể làm việc theo hai cách: nhập lệnh trực tiếp hoặc sử dụng menu để tạo cú pháp tương ứng. Cách làm việc bằng lệnh tuy có vẻ phức tạp ban đầu nhưng lại mang lại lợi ích lớn về khả năng tái lập (reproducibility) — tất cả các bước phân tích có thể lưu thành file do-file và chạy lại bất cứ lúc nào để kiểm tra hoặc áp dụng cho dataset mới.
Phần mềm cũng có tính năng "do-file editor" tích hợp, cho phép viết và lưu chuỗi các lệnh thành script. Cơ chế này hoạt động như một bản ghi lại toàn bộ quy trình phân tích từ nhập dữ liệu, làm sạch, biến đổi đến mô hình hóa và xuất kết quả. Khi cần sửa đổi hoặc kiểm tra lại, chỉ cần chỉnh sửa do-file và chạy lại toàn bộ script thay vì thực hiện thủ công từng bước qua menu. Điều này đặc biệt quan trọng trong nghiên cứu kinh tế lượng, nơi quy trình phân tích thường phức tạp và cần nhiều lần tinh chỉnh.
Cơ chế xử lý dữ liệu và biến đổi
Điểm mạnh của Stata nằm ở khả năng xử lý và biến đổi dữ liệu linh hoạt thông qua các lệnh quản lý dữ liệu (data management commands). Khác với Excel hay SPSS thiên về thao tác chuột, Stata sử dụng cú pháp lệnh cho phép thực hiện các phép biến đổi phức tạp một cách nhanh chóng và tái lập được. Các lệnh cơ bản như generate, replace, egen, reshape, merge và append là công cụ chính cho việc chuẩn bị dữ liệu trước khi phân tích.
Cơ chế của lệnh generate và replace hoạt động trên từng observation của dataset: generate newvar = expression tạo biến mới từ biểu thức toán học hoặc logic, trong khi replace oldvar = expression sửa giá trị của biến đã có. Lệnh egen (extension of generate) mở rộng khả năng này với các hàm thống kê tích hợp như mean(), sum(), max(), rowtotal() cho phép tạo biến tổng hợp theo nhóm hoặc theo row. Đội ngũ biên tập EduCentury nhận thấy nhiều sinh viên mới gặp khó khăn với việc phân biệt khi nào dùng generate và khi nào dùng egen — quy tắc cơ bản là dùng generate cho biểu thức đơn giản, egen khi cần hàm thống kê.
Lệnh reshape giải quyết vấn đề chuyển đổi giữa dạng wide (mỗi observation là một đối tượng, các biến theo thời gian nằm ở các cột khác nhau) và dạng long (mỗi observation là một cặp đối tượng-thời gian). Cơ chế này hoạt động dựa trên việc xác định biến định danh (i) và biến thời gian (j), sau đó phân bổ giá trị từ các cột wide thành các observation long hoặc ngược lại. Trong nghiên cứu kinh tế lượng, dạng long thường thuận tiện hơn cho các mô hình panel data vì lệnh phân tích có thể nhận biết cấu trúc theo thời gian tự nhiên.
Lệnh merge và append cho phép kết hợp dữ liệu từ nhiều nguồn khác nhau. Cơ chế của merge dựa trên việc so khớp key variable(s) giữa hai dataset và đưa các biến từ dataset phụ vào dataset chính theo các kiểu merge 1:1, 1:m, m:1 hoặc m:m. Quan trọng là phải sort key variables bằng lệnh sort trước khi merge, kiểm tra các observation không match thông qua biến _merge được tạo tự động sau merge. Lệnh append đơn giản hơn: nối các observation của dataset phụ vào dataset chính khi có cùng cấu trúc biến, không cần key variable.
Phân tích kinh tế lượng với Stata
Nghiên cứu kinh tế lượng sử dụng Stata chủ yếu qua các lệnh regress, logit, probit, tobit, glm, xtgls, xtreg, xtabond2 và nhiều lệnh khác tùy thuộc vào loại dữ liệu (cross-section, time series, panel data) và đặc điểm của biến phụ thuộc (continuous, binary, count, ordinal). Mỗi lệnh có cú pháp chuẩn là command depvar [indepvars] [if] [in] [weight] [, options], cho phép điều chọn mẫu, gán trọng số và thêm các tùy chọn cụ thể cho từng mô hình.
Lệnh regress cho mô hình hồi quy tuyến tính OLS (Ordinary Least Squares) là công cụ cơ bản nhất trong kinh tế lượng. Cơ chế OLS hoạt động theo nguyên tắc giảm thiểu tổng bình phương phần dư: thuật toán tìm các tham số β sao cho sum(ε²) đạt giá trị nhỏ nhất, với ε = y - Xβ. Khi chạy lệnh regress y x1 x2 x3, Stata sẽ tính toán ma trận (X'X)^(-1)X'y để ước lượng β, đồng thời tính toán thống kê t, p-value, R² và các kiểm định chuẩn khác. Trong phân tích EduCentury, OLS thường được dùng làm mô hình baseline để so sánh với các phương pháp ước lượng khác như IV (Instrumental Variable), GMM hay MLE (Maximum Likelihood Estimation).
Sau khi chạy mô hình, lệnh predict cho phép tạo các biến dự báo như giá trị dự báo (yhat), phần dư (residuals), standardized residuals, leverage, Cook's distance và nhiều chỉ số khác. Cơ chế của predict là lấy các tham số đã ước lượng từ mô hình gần nhất và áp dụng công thức tính toán tương ứng lên từng observation. Việc kiểm tra các phần dư là bước quan trọng để xác định các giả định của mô hình có được thỏa mãn hay không: phần dư nên có phân phối chuẩn, phương sai đồng nhất (homoskedasticity) và không có hiện tượng tự tương quan (autocorrelation).
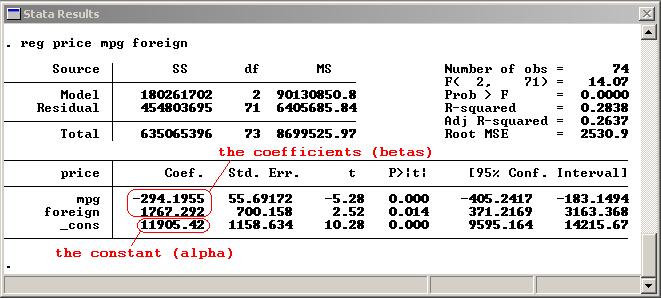
Các lệnh kiểm định sau hồi quy như estat hettest (kiểm định heteroskedasticity), estat vif (Variance Inflation Factor để kiểm tra đa cộng tuyến), dwstat (Durbin-Watson cho tự tương quan trong time series) và estat ovtest (omitted variable test) giúp đánh giá chất lượng mô hình. Cơ chế của estat hettest dựa trên kiểm định Breusch-Pagan: chạy hồi quy phụ của bình phương phần dư lên các biến độc lập để kiểm tra xem phương sai phần dư có phụ thuộc vào biến độc lập hay không. Nếu p-value < 0.05, bác bỏ giả thuyết phương sai đồng nhất, cần sử dụng robust standard error hoặc phương pháp ước lượng phù hợp như GLS (Generalized Least Squares).
Lập trình và tự động hóa phân tích
Một trong những ưu điểm lớn của Stata là khả năng lập trình qua cú pháp do-file, Mata (ngôn ngữ lập trình ma trận tích hợp) và khả năng tạo package mới. Do-file không chỉ lưu chuỗi lệnh mà còn cho phép sử dụng các cấu trúc lập trình như vòng lặp (foreach, forvalues), điều kiện (if, else), macro và program tự định nghĩa. Điều này đặc biệt hữu ích khi cần phân tích nhiều nhóm, chạy nhiều mô hình với biến khác nhau hoặc tạo báo cáo tự động.
Cơ chế của vòng lặp foreach hoạt động bằng cách định nghĩa một list các giá trị (biến, chuỗi, số) và lặp lại khối lệnh cho từng giá trị trong list đó. Ví dụ: foreach var of varlist x1 x2 x3 { summarize var' }sẽ chạy lệnhsummarizecho ba biến x1, x2, x3. Lệnhforvaluestương tự nhưng cho vòng lặp số:forvalues i = 1/10 { display "Iteration i'" } sẽ lặp từ 1 đến 10. Cơ chế này giúp giảm thiểu lặp code và dễ dàng mở rộng quy trình phân tích khi số lượng biến hoặc nhóm tăng lên.
Macro trong Stata có hai loại: local macro và global macro. Local macro tồn tại trong phạm vi do-file hoặc lệnh đang chạy, được gọi bằng cú pháp `macroname' (backtick trước và apostrophe sau). Global macro tồn tại trong suốt session Stata, được gọi bằng $macroname. Cơ chế macro hoạt động theo nguyên tắc text replacement: khi Stata gặp tên macro trong lệnh, nó sẽ thay thế bằng giá trị của macro trước khi thực thi lệnh. Điều này cho phép viết lệnh linh hoạt: regress y indepvars'vớiindepvars` là một list các biến có thể thay đổi tùy theo mô hình.
Mata là ngôn ngữ lập trình ma trận tích hợp trong Stata, cho phép viết thuật toán tùy chỉnh phức tạp khi các lệnh có sẵn không đáp ứng được. Cơ chế của Mata hoạt động trực tiếp trên ma trận và vector với cú pháp giống các ngôn ngữ như MATLAB hay R, nhưng có lợi thế là tích hợp chặt chẽ với data in memory của Stata. Mata đặc biệt hữu ích cho các mô hình kinh tế lượng cao cấp như bayesian inference, MCMC hoặc các phương pháp ước lượng không có sẵn dưới dạng lệnh Stata. Quan điểm của EduCentury là sinh viên nên bắt đầu với do-file và các lệnh cơ bản trước khi học Mata, vì phần lớn nghiên cứu thông thường có thể giải quyết bằng các lệnh built-in.
Các tài nguyên và hỗ trợ học tập Stata
Việc học Stata hiệu quả đòi hỏi kết hợp giữa tài liệu chính thức, thực hành trên dataset thật và tham khảo các ví dụ từ nghiên cứu đã công bố. StataCorp cung cấp tài liệu chi tiết cho từng lệnh qua lệnh help [commandname] trong Stata hoặc trực tuyến tại website stata.com. Các manual như Stata Base Reference Manual, Stata User's Guide và Stata Programming Reference Manual là nguồn kiến thức chính thống nhưng cần có kiến thức nền tảng để hiểu đầy đủ.
Các dataset mẫu như auto.dta, wage1.dsa, mroz.dta được cài sẵn cùng Stata là cơ sở tốt để thực hành. Cơ chế học bằng ví dụ (learning by example) hoạt động hiệu quả với Stata vì cú pháp lệnh khá trực quan: người dùng có thể xem các lệnh mẫu trong manual, chạy thử trên dataset có sẵn và hiểu cách lệnh hoạt động thông qua kết quả đầu ra. EduCentury nhận thấy sinh viên thường học nhanh hơn khi bắt đầu với dataset có sẵn thay vì tự thu thập dữ liệu ngay từ đầu, vì việc focus vào cú pháp và kết quả phân tích sẽ dễ dàng hơn.
Cộng đồng người dùng Stata trên thế giới và tại Việt Nam cũng là nguồn hỗ trợ quan trọng. Các diễn đàn như Statalist (mailing list chính thức của StataCorp), Stack Overflow (tag: stata) và các nhóm Facebook như "Stata Users" cung cấp nhiều câu hỏi và giải pháp cho các vấn đề cụ thể. Tuy nhiên, khi tìm kiếm giải pháp, cần kiểm tra kỹ phiên bản Stata được đề cập trong câu trả lời vì các tính năng và lệnh có thể thay đổi giữa các phiên bản.
Ngoài ra, nhiều cuốn sách chuyên biệt về kinh tế lượng với Stata như "Introduction to Econometrics with Stata" của Christopher F. Baum hay "Econometric Analysis of Cross Section and Panel Data" của Jeffrey M. Wooldridge (có ví dụ Stata) là tài liệu tham khảo giá trị. Các sách này không chỉ dạy cú pháp Stata mà còn giải thích cơ chế kinh tế lượng đứng sau từng mô hình — hai mảng kiến thức này cần song hành để thực hiện nghiên cứu khoa học đúng cách.
Câu hỏi thường gặp
Stata có khó học hơn SPSS không?
Stata có vẻ khó hơn ở giai đoạn đầu vì cần học cú pháp lệnh thay vì thao tác chuột như SPSS. Tuy nhiên, sau khi làm quen với các lệnh cơ bản, Stata lại linh hoạt hơn nhiều: có thể viết script để tự động hóa quy trình, áp dụng lại cho dataset mới và tái lập kết quả. SPSS mạnh về giao diện trực quan nhưng hạn chế trong khả năng lập trình. Nếu mục tiêu là nghiên cứu khoa học bài bản, thời gian đầu đầu tư học Stata sẽ đáng giá về lâu dài.
Tôi nên chọn phiên bản Stata nào?
Đối với sinh viên và nghiên cứu cá nhân, Stata/BE (Basic Edition) thường đủ dùng với giới hạn 2048 biến. Nếu làm việc với dataset lớn hoặc cần xử lý nhiều biến, Stata/SE là lựa chọn phù hợp. Stata/MP với khả năng xử lý song song (multi-core) thường dành cho các nghiên cứu quy mô lớn hoặc doanh nghiệp. Hầu hết trường đại học và viện nghiên cứu tại Việt Nam sử dụng Stata/SE hoặc Stata/MP trong phòng thí nghiệm.
Stata có thể xử lý dữ liệu lớn bao nhiêu?
Giới hạn kích thước dữ liệu phụ thuộc vào phiên bản Stata và cấu hình máy. Stata/BE hỗ trợ tối đa 2048 biến, Stata/SE hỗ trợ tối đa 32,767 biến, trong khi Stata/MP không giới hạn số lượng biến (chỉ phụ thuộc RAM). Về số lượng observation, tất cả phiên bản đều hỗ trợ tối đa 2.1 tỷ observation. Trong thực tế, phần lớn nghiên cứu kinh tế lượng không vượt quá giới hạn này, nhưng khi làm việc với big data, R hay Python có thể phù hợp hơn.
Làm sao để học Stata nhanh nhất?
Cách hiệu quả nhất là kết hợp ba phương pháp: (1) đọc tài liệu chính thức của từng lệnh qua help, (2) thực hành trên dataset mẫu có sẵn và (3) xem các do-file mẫu từ nghiên cứu đã công bố hoặc giáo trình. Bắt đầu với các lệnh cơ bản như describe, summarize, tabulate, regress, sau đó học data management (generate, replace, merge) và cuối cùng là các lệnh chuyên sâu hơn. EduCentury khuyến nghị nên dành thời gian học cú pháp lệnh ngay từ đầu thay vì phụ thuộc vào menu.
Stata có miễn phí không?
Stata là phần mềm thương mại với bản quyền được bán theo license vĩnh viễn hoặc thuê theo năm. Giá tùy thuộc vào phiên bản (BE/SE/MP) và loại người dùng (sinh viên, giáo viên, doanh nghiệp). Tuy nhiên, nhiều trường đại học cung cấp Stata miễn phí cho sinh viên thông qua phòng thí nghiệm hoặc license trường. Ngoài ra, có bản dùng thử thời hạn (trial) và các bản giáo dục giảm giá. Các lựa chọn thay thế miễn phí là R, Python với gói pandas/statsmodels hay Gretl — nhưng cú pháp và quy trình làm việc sẽ khác.
Khám phá
Thúc đẩy tư duy phản biện trong giáo dục phổ thông
Review phần mềm học tiếng Anh giao tiếp hiệu quả
Chinh phục tiếng Anh trong 4 năm đại học: Lộ trình toàn diện cho sinh viên
Hướng dẫn chi tiết cách phát hiện và sửa lỗi sai trong câu tiếng Anh dành cho học sinh THCS